Cómo crear una wiki legal automatizada mediante IA

CALENDARIO de próximos CURSOS 😄
El 4 de abril de 2026, Andrej Karpathy (co-fundador de OpenAI, director de IA en Tesla y ahora en Anthropic) publicó en GitHub un "archivo de ideas" titulado LLM Wiki. Su tesis cabía en una línea: "Obsidian es el IDE; el LLM es el programador; la wiki es la base de código".
¿Eso cómo se traduce en legal?
Obsidian es una aplicación para tomar y organizar notas y conocimiento personal que se guarda localmente y que puedes enlazar entre sí. Por tanto, Obsidian o herramientas equivalentes serían tu entorno de trabajo.
El LLM es el chatbot de IA que hace de abogado asistente e interpreta instrucciones, redacta, resume, compara y trabaja sobre ese material recopilado.
La wiki es un espacio de conocimiento organizado en páginas enlazadas entre sí y que se pueden actualizar fácilmente. Por ejemplo, el conjunto de precedentes, criterios internos, modelos, notas y referencias que sirven de base para trabajar.
Por tanto, cuando Karpathy dice que "Obsidian es el IDE; el LLM es el programador; la wiki es la base de código", está hablando de la posibilidad que tiene un despacho de acumular su conocimiento de forma estructurada y que lo gestione una IA.
Sin duda es una idea atractiva, así que había que probarla en algo real.
En marzo de 2025 lancé el glosario sobre IA y Derecho prometiendo un "working in progress semanal". Diecisiete meses después tenía 58 términos en una sola página, tocada por última vez en septiembre de 2025. Lo de semanal fue, digamos, aspiracional 😅
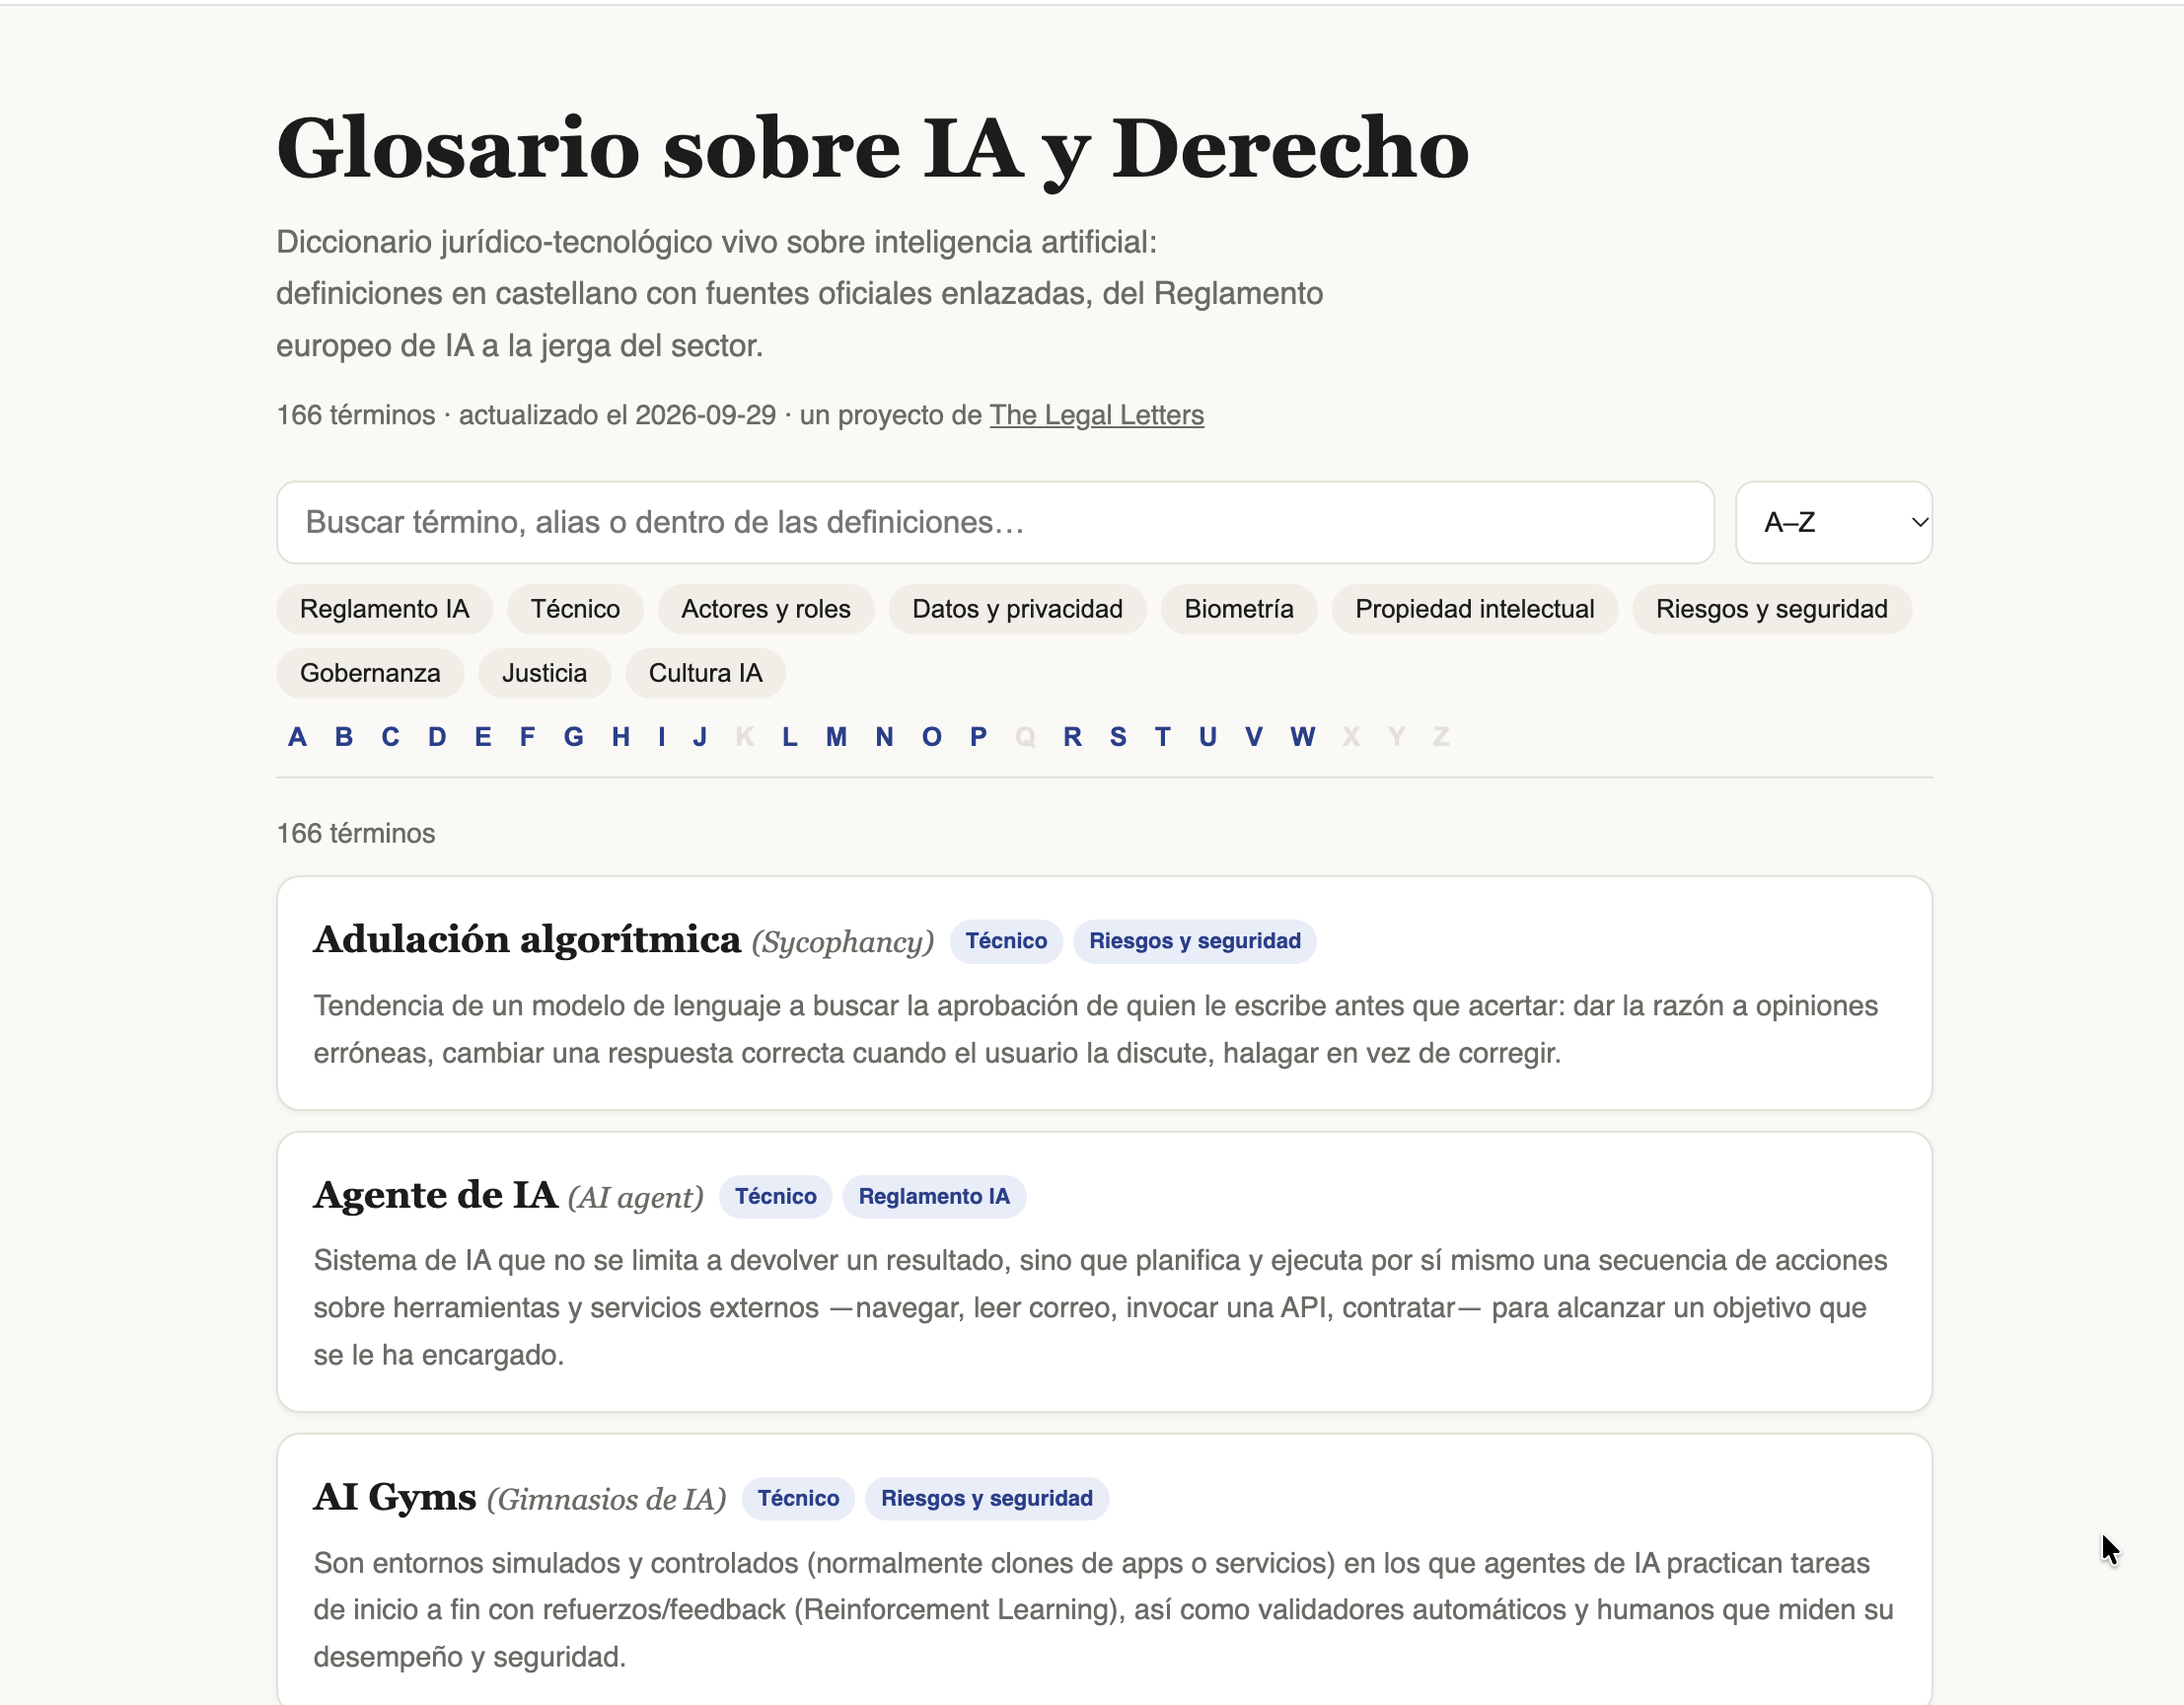
Hoy el nuevo glosario tiene 166 términos, recibe propuestas nuevas cada lunes sin que yo mueva un dedo y se ha revisado entero contra el Ómnibus digital.
Vamos a ver cómo lo he conseguido y podría copiarse en otros ámbitos.
La idea de Karpathy o el wiki que no escribes tú
Casi todos usamos la IA con documentos al estilo "base de datos": es decir, subes archivos y el modelo busca fragmentos en cada pregunta. Por ejemplo, NotebookLM (ahora Gemini Notebook). Funciona, pero poco de eso se acumula.
La propuesta que hacía Karpathy es la inversa: la IA lee cada fuente una vez, la integra en archivos enlazados, señala contradicciones y lo mantiene todo al día. Por tanto, tú pones las fuentes y el criterio de lo que se añade o no; la IA hace las tareas de archivero.
En materia legal, es la diferencia entre releer las guías de la AEPD cada vez que un cliente pregunta por la EIPD o tener una ficha por concepto que alguien actualiza cuando sale la siguiente guía. Vamos, cocinar cada noche desde cero o abrir un congelador con los tuppers etiquetados.
Sin Obsidian o la carpeta de toda la vida
Yo no quería otra aplicación (Obsidian, aunque sea muy buena), y en verdad no hace falta: un "bául de conocimiento" como los que proporciona Obsidian no es más que una carpeta de archivos en formato Markdown, y eso Claude Code o ChatGPT Codex lo manejan de forma nativa.
Así que elegí Claude Code (pero ya digo que puede hacerse sin problema en ChatGPT, usando la aplicación de escritorio) para crear mi glosario/wiki automatizado sobre IA y Derecho, que hasta la fecha había estado ejecutando con ideas de hace 40 años.
La arquitectura en verdad es muy sencilla (aunque de inicio suene técnico, luego lo bajaremos más al suelo):
- Una ficha por término: un archivo con una cabecera de metadatos (categorías, términos relacionados, fecha y estado: borrador o publicado).
- Un Claude/ChatGPT.md: la línea editorial. Primera frase como definición autónoma, ángulo jurídico obligatorio, fuente oficial primero y categorías cerradas.
- Un script de publicación: convierte la carpeta en una web con buscador, filtros y enlaces cruzados, alojada gratis en GitHub Pages, más un JSON con los datos en abierto bajo CC BY 4.0.
Lo anterior se traduce de la siguiente manera: coloqué el contenido de mi glosario original en una carpeta del ordenador, le dije a Claude cuál era el libro de estilo que la IA debía respetar al redactar nuevo contenido a partir del existente (una ficha por término, con su materia, los conceptos relacionados, la fecha, etc.) y el mismo Claude debía encargarse de convertirlo todo en una web pública con buscador, gratis y que se actualizara solo, según mi dirección.
Es el fichero de cartulinas de la biblioteca del colegio, solo que el que rellena las fichas no se cansa nunca 🧩
Las skills o el manual del becario
Aquí se produce el salto cualitativo.
Como conté con el fenómeno de las skills legales, una skill es un procedimiento escrito que Claude o ChatGPT sigue al pie de la letra. El glosario tiene cinco: añadir término, vaciar la bandeja de entrada, vigilar, revisar y publicar.
Eso significa que en la bandeja suelto enlaces, notas o el PDF de una propuesta de norma o guía. A efectos prácticos la bandeja de entrada de esta wiki es una carpeta donde deposito cosas que veo interesantes, o directamente el propio Claude. Claude revisa esas fuentes que le proporciono y extrae de ahí términos que podrían ser relevantes para el glosario (en función de las pautas anteriormente definidas). En el caso de documentos largos, Claude no redacta a ciegas: primero me propone candidatos con su artículo o página, y yo elijo.
La vigilancia es el "casi tiempo real". Cada lunes a las 08:00 una tarea programada revisa la Oficina de IA, la AEPD, el CEPD y la prensa técnica que yo he elegido. Por ejemplo, el último lunes detectó el Real Decreto 723/2026, publicado en el BOE el 15/09/2026, cuyo art. 3.2.k) obliga a informar al trabajador de la existencia de sistemas algorítmicos de decisión. De ahí salió el término "Gestión algorítmica", que Claude que sugirió como candidato a añadir al glosario. Eso sí, Claude nunca publica por su cuenta: los borradores esperan mi visto bueno.
Además, antes de dar por buena una cita a norma española, la contrasta con el corpus de legislación consolidada de Legalize, conectado por MCP. No es infalible: el Real Decreto 723/2026 aún no estaba en ese corpus y hubo que ir al BOE. Pero es una forma de tener un becario que te deja los borradores el lunes con los artículos comprobados y sabe que nada sale al cliente sin tu firma 👀
Seis semanas después o el efecto compuesto
Arranqué el 16 de agosto migrando los 58 términos originales al nuevo estilo de glosario. A 29 de septiembre van 166, con cinco vigilancias y 19 términos salidos de cribar las miles noticias de 2026 de mi hemeroteca particular.
Pero lo más valioso no fue solo escribir, también mantener.
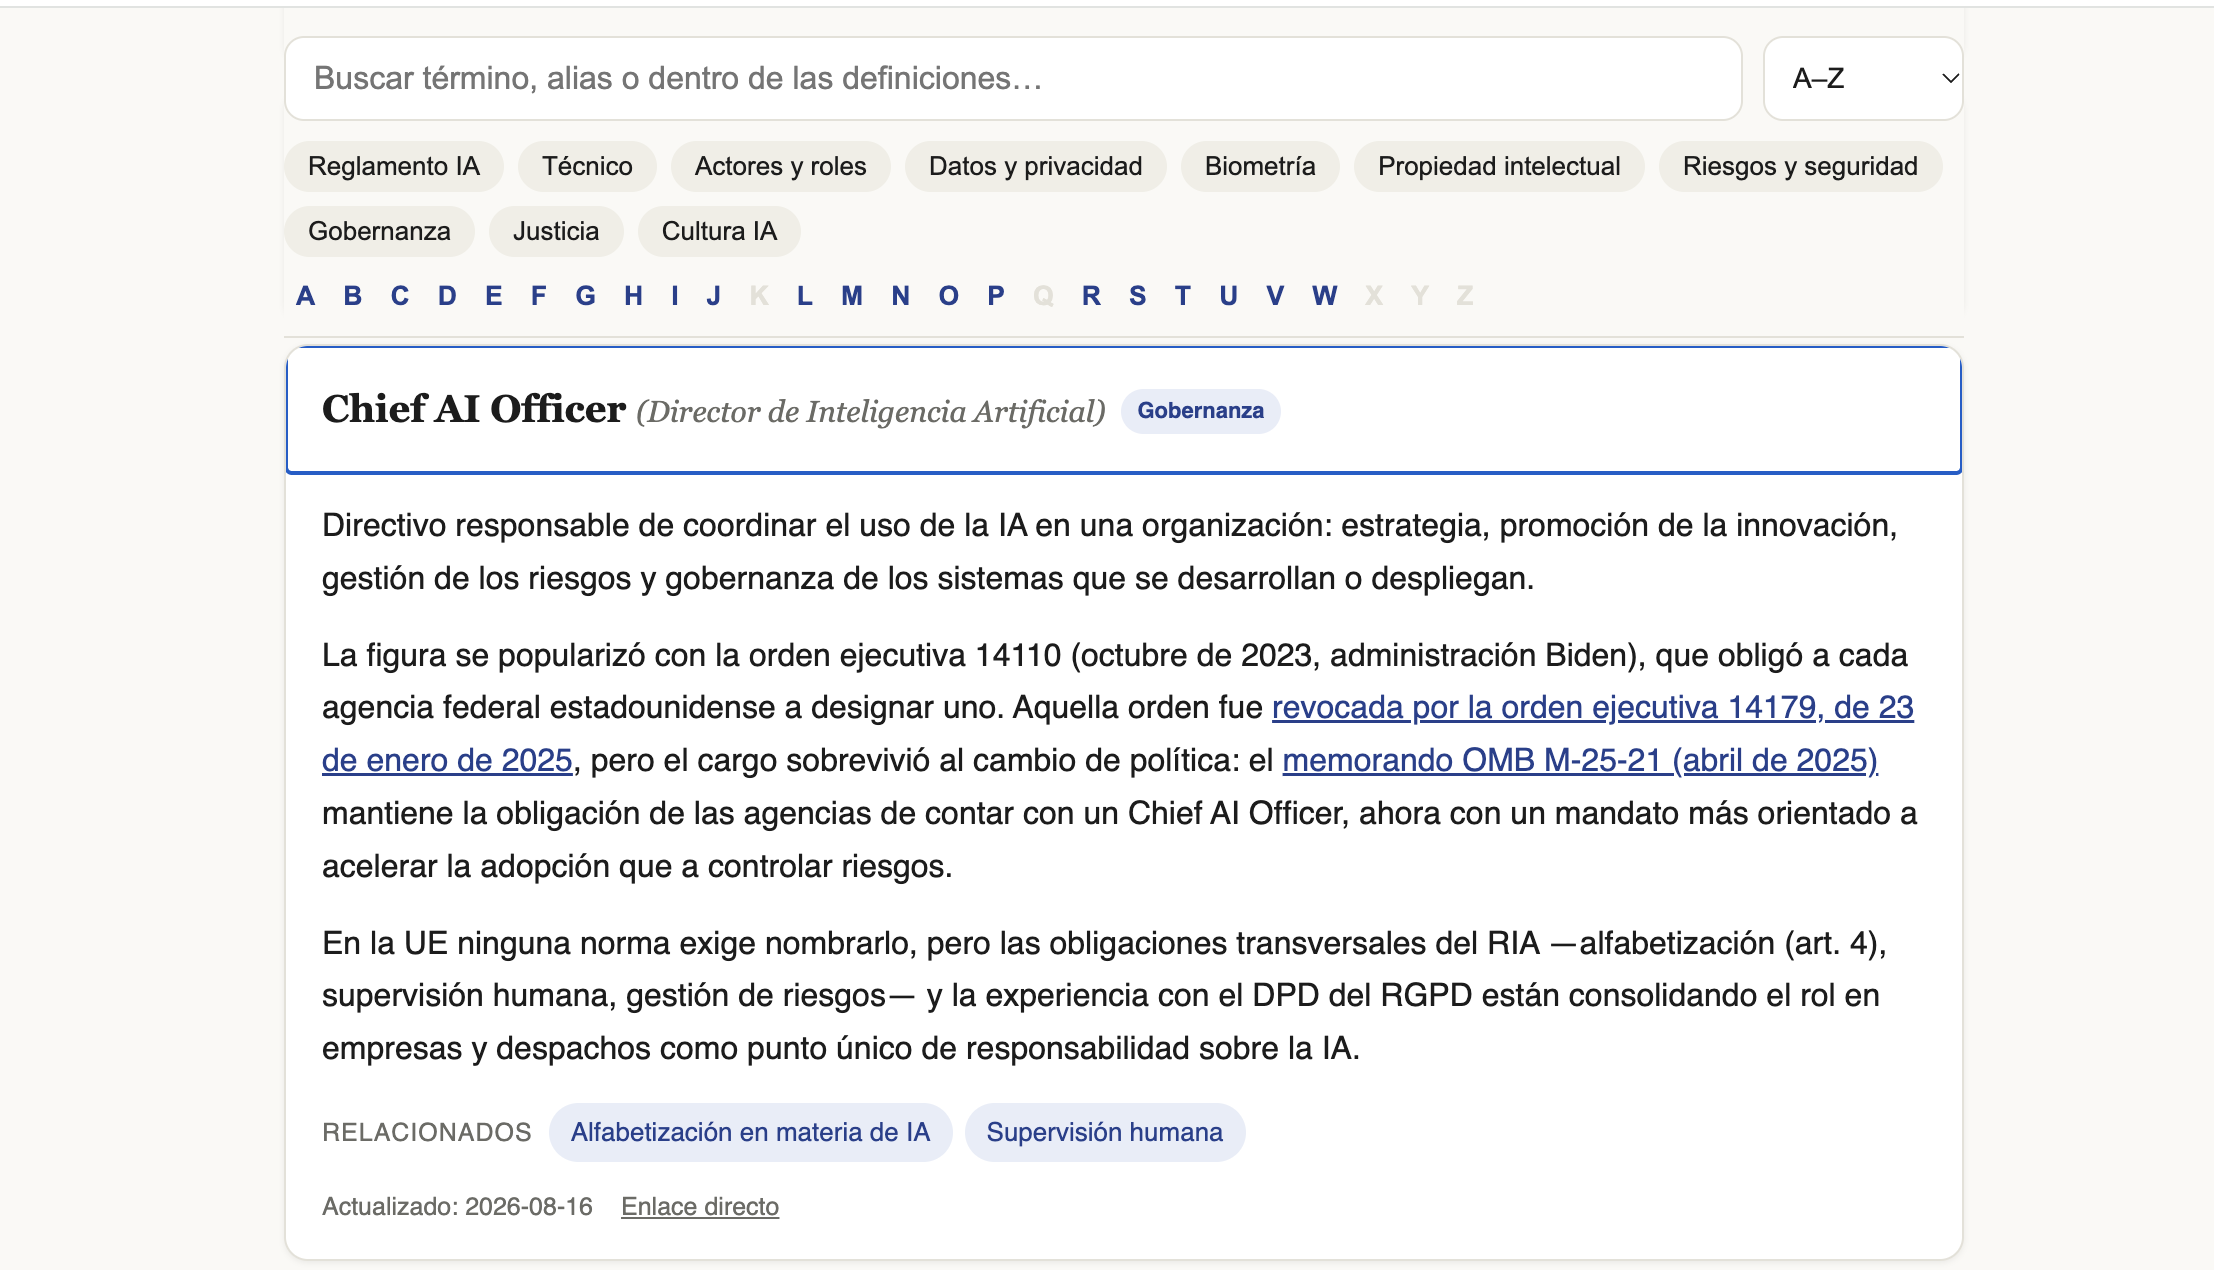
La primera revisión encontró erratas y términos anticuados: 12 no citaban fuente, «LLM» solo remitía a otra entrada y el Chief AI Officer se apoyaba en una orden ejecutiva de Biden revocada en enero de 2025.
Luego llegó el Reglamento (UE) 2026/1744, el Ómnibus digital sobre IA. Claude cruzó los 46 términos que citaban artículos concretos del RIA con mi comparador de versiones y actualizó 13. Mi glosario decía que el art. 4 obliga a adoptar medidas para «garantizar» un nivel suficiente de alfabetización en IA; hoy basta con «apoyar la promoción». Y la «ultrasuplantación» pasó a ser «ultrafalsificación» por la corrección de errores, con redirección del enlace antiguo para no romper las citas de terceros.
Eso quiere decir que crear una base de conocimiento (como por ejemplo mi glosario jurídico) sin valorar las opciones actuales de la IA, es una iniciativa estática que no solo se queda corta, sino que seguramente afirmará cosas que ya no son ciertas. Sin embargo, ahora podemos disponer de un encargado incansable de revisar y mantener al día el contenido, y siempre bajo nuestro criterio final (ya que alguna metedura de pata puede haber).
Ello sin duda cambia el concepto de gestionar conocimiento, del tipo que sea 📚
¿Y en otra materia?
El patrón que yo he aplicado para convertir mi glosario estático en uno automatizado y dinámico sirve donde haya conceptos que se definen en normas, se matizan en doctrina o cambian a menudo. Los pasos son los mismos: pegar a Claude Code el archivo de Karpathy, crear una ficha por concepto, escribir el CLAUDE.md y definir tres operaciones (ingerir, vigilar y revisar). Publicar es opcional; el valor está en la carpeta.
Sé que lo anterior suena complicado, por tanto, usad un PROMTP como éste (con los ajustes correspondientes en cada caso) y le pedís a vuestro, Claude, ChatGPT o IA de confianza lo siguiente para empezar vuestra base de conocimiento dinámica:
Quiero que montes conmigo una «LLM Wiki» siguiendo el patrón que Andrej Karpathy describe aquí: https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
(léelo antes de empezar). No usaré Obsidian: la wiki será una carpeta de archivos Markdown que tú redactas y mantienes, y yo reviso.
MI WIKI
- Materia: [p. ej. «protección de datos», «derecho laboral», «nutrición deportiva»]
- Para quién es: [p. ej. «abogados de mi despacho», «clientes», «mis alumnos», «solo yo»]
- Idioma: [español]
- Ángulo obligatorio de cada ficha: [p. ej. «consecuencia jurídica práctica»,
«aplicación clínica», «cómo se explica en clase»] - Fuentes por orden de autoridad: [p. ej. «1) normas oficiales (BOE, EUR-Lex),
2) autoridades (AEPD, CEPD), 3) doctrina y prensa especializada»] - Fuentes que vigilar periódicamente: [URLs o nombres]
- Herramientas de verificación disponibles: [p. ej. «conector MCP de legislación
consolidada», «ninguna, usa la web»] - Material de partida: [ruta a documentos, glosario antiguo o URL; o «ninguno»]
- ¿Contendrá información confidencial?: [sí / no]
- ¿Quiero publicarla en la web?: [sí / no]
QUÉ TIENES QUE CREAR
1.- Una carpeta `fichas/` con un archivo Markdown por concepto y esta cabecera: concepto, alias, slug, categorías, relacionados, actualizado: AAAA-MM-DD estado: borrador | publicado. En el cuerpo, la primera frase debe ser una definición que se entienda sola; después, el ángulo obligatorio; y las fuentes, enlazadas dentro del texto.
2.- Un archivo.md con la línea editorial: formato de ficha, extensión, tono,
jerarquía de fuentes y una taxonomía cerrada de categorías (propónme una de
6 a 10 y espera mi visto bueno). Incluye siempre estas reglas:
- Nada se afirma sin una fuente enlazada; si algo no se puede verificar, se dice.
- Nunca se borra una ficha: para retirarla, se pasa a borrador.
- Todo lo nuevo nace como borrador y solo yo lo paso a publicado.
- Si hay información confidencial, nada sale de mi equipo: ni web, ni
repositorio público, ni servicios externos que yo no haya autorizado.
3.- Tres operaciones, cada una como su propia skill:
- Ingerir: procesa lo que deje en la bendaje, la carpeta o directamente en el campo de escritura (URLs, notas, PDFs). Con documentos largos, primero me propone los conceptos candidatos con su página o artículo y espera a que elija; después redacta, enlaza con las fichas existentes y archiva lo procesado indicando qué fichas generó.
- Vigilar: revisa las fuentes que vigilar, propone fichas nuevas y detecta
fichas que un cambio ha dejado desfasadas. Deja borradores y un informe;
nunca publica. - Revisar: chequeo de salud. Cabeceras incompletas, enlaces rotos,
fichas sin fuente, fichas a las que nadie enlaza, contradicciones entre
fichas y citas desactualizadas. Arregla lo mecánico y me propone lo de
contenido.
4.- Solo si he dicho que quiero publicarla: un script sin dependencias que
convierta fichas/ (solo las publicadas) en una web estática con buscador,
filtros por categoría y enlaces entre fichas, lista para GitHub Pages, y una
skill publicar que la regenere y la suba.
CÓMO TRABAJAR
- Antes de crear nada, pregúntame lo que falte o no esté claro de lo anterior.
- Después crea la estructura, migra mi material de partida si lo hay y
enséñame 3 fichas de muestra para ajustar el estilo antes de hacer el resto. - Al terminar, prográmame "vigilar" como tarea semanal y explícame en cinco
líneas cómo usar cada operación.
Moraleja
Lo verdaderamente útil que extraigo de esta nueva versión del glosario no es haber pasado de 58 a 166 términos (y creciendo) en poco más de un mes, sino disponer de un sistema automatizado que avisa cuando uno de ellos ha dejado de ser cierto u otro comienza a ser relevante.
En el fondo es la capacidad que tenemos hoy de delegar el montaje de la base de datos y la fijación de nuestras reglas, dejando que la IA haga el trabajo de archivo cada lunes pero reservándonos la firma y el criterio.
Por tanto, la clave de la conversión de mi glosario de algo clásico y muy estático a un sistema dinámico y automatizado, no creo que esté tanto en quién escribe ahora las fichas (mucho más la IA que yo), sino en quién las guía, estructura y revisa cada lunes 🤖
Jorge Morell Ramos
Destacados de la semana (21 a 27 de septiembre de 2026):